В търсене на най-добрия A.I. преводач на художествена литература
Жена ми чете по-бързо, отколкото у нас се превеждат книги. Част от тези, които иска, ги няма на български и едва ли някога ще ги има, защото пазарът е малък и преводът не се изплаща.
Затова пробвах машинен превод. Излезе нечетимо: изречения, които са граматически верни и не значат нищо, и диалог, пунктуиран като на английски. Жена ми стигна до трийсетата страница и се отказа.
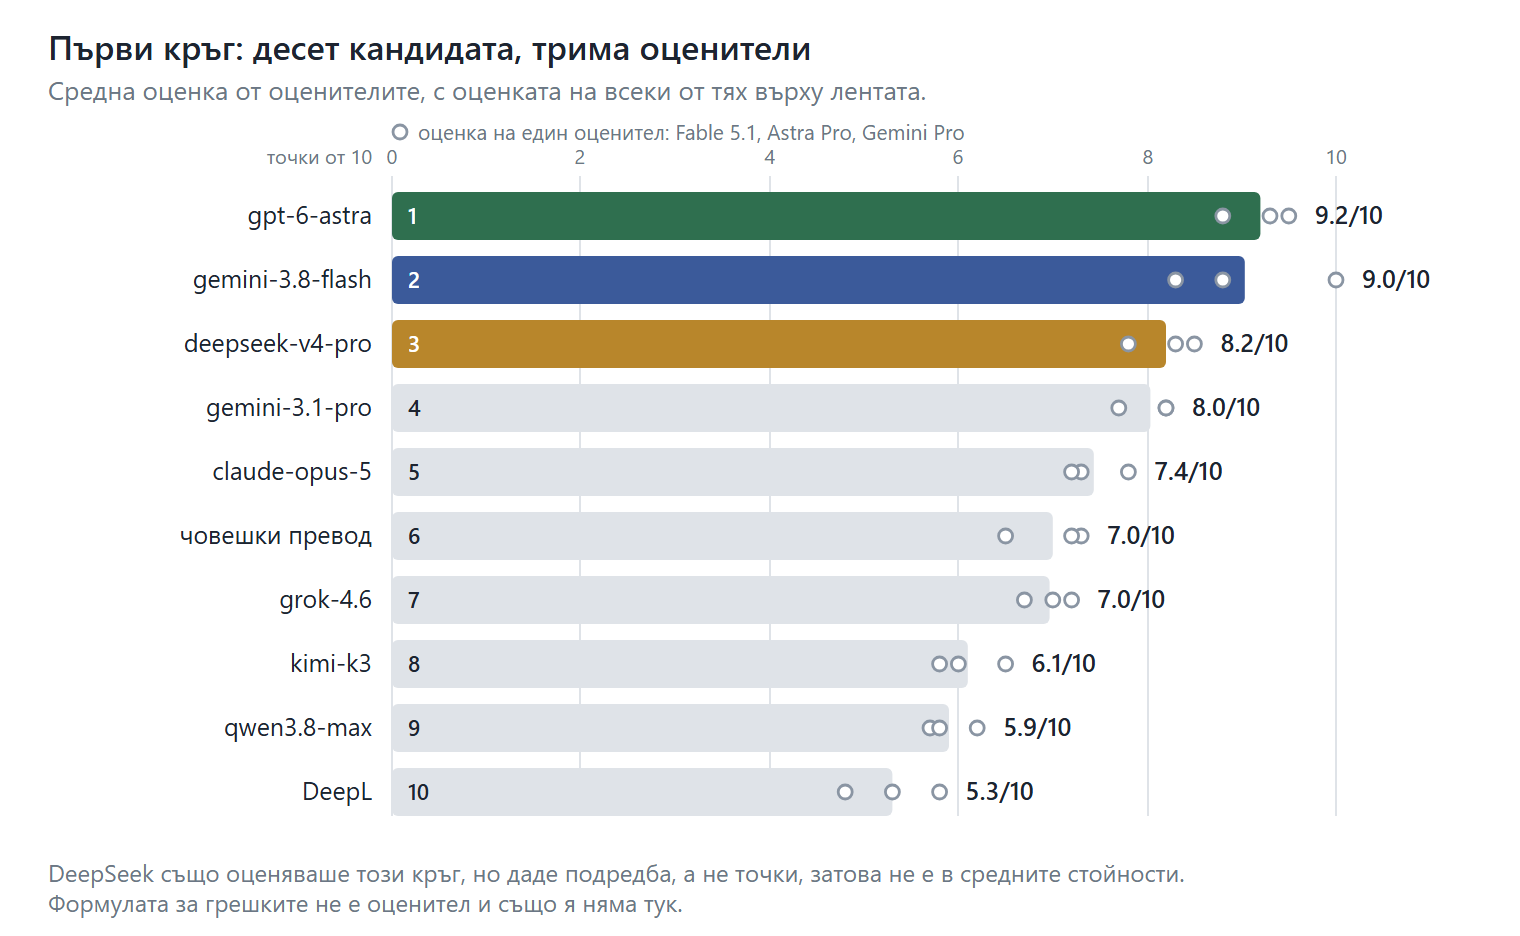
Започнах с DeepL, за който навсякъде пише, че е най-добрият. Оказа се, че това са приказки без покритие, и по-късно в теста излезе последен от десет.
Същото стана и с qwen3.8-max. Включих го в теста само защото уж е най-добрият модел за преводи. В резултатите излезе предпоследен и беше единственият, който изпуска части от текста. Пак приказки без покритие.
Как тествах AI преводачите
Тогава реших да направя собствено изследване и да видя кой AI преводач наистина се справя най-добре. Взех разказ на Робърт Хауърд от около 12 000 думи, който има и издаден превод от човек, и го дадох на осем езикови модела и на DeepL. Всички получиха дума по дума една и съща задача.
За оценяването избрах четири модела от четири различни производителя. Всеки от тях има свой роднина сред преводачите и може леко да го глези, така че с четирима пристрастието се разрежда, а и се вижда дали оценките им съвпадат. Сложих и няколко правила. Оценителите не знаят кой какво е превел и оценяват всички преводи наведнъж, за да мерят с една и съща скала. Проверих и дали моделите не са виждали издадения превод, докато са се обучавали, защото тогава щяха просто да си го спомнят. Не намерих следа от това.
Кой AI преводач излезе най-добър
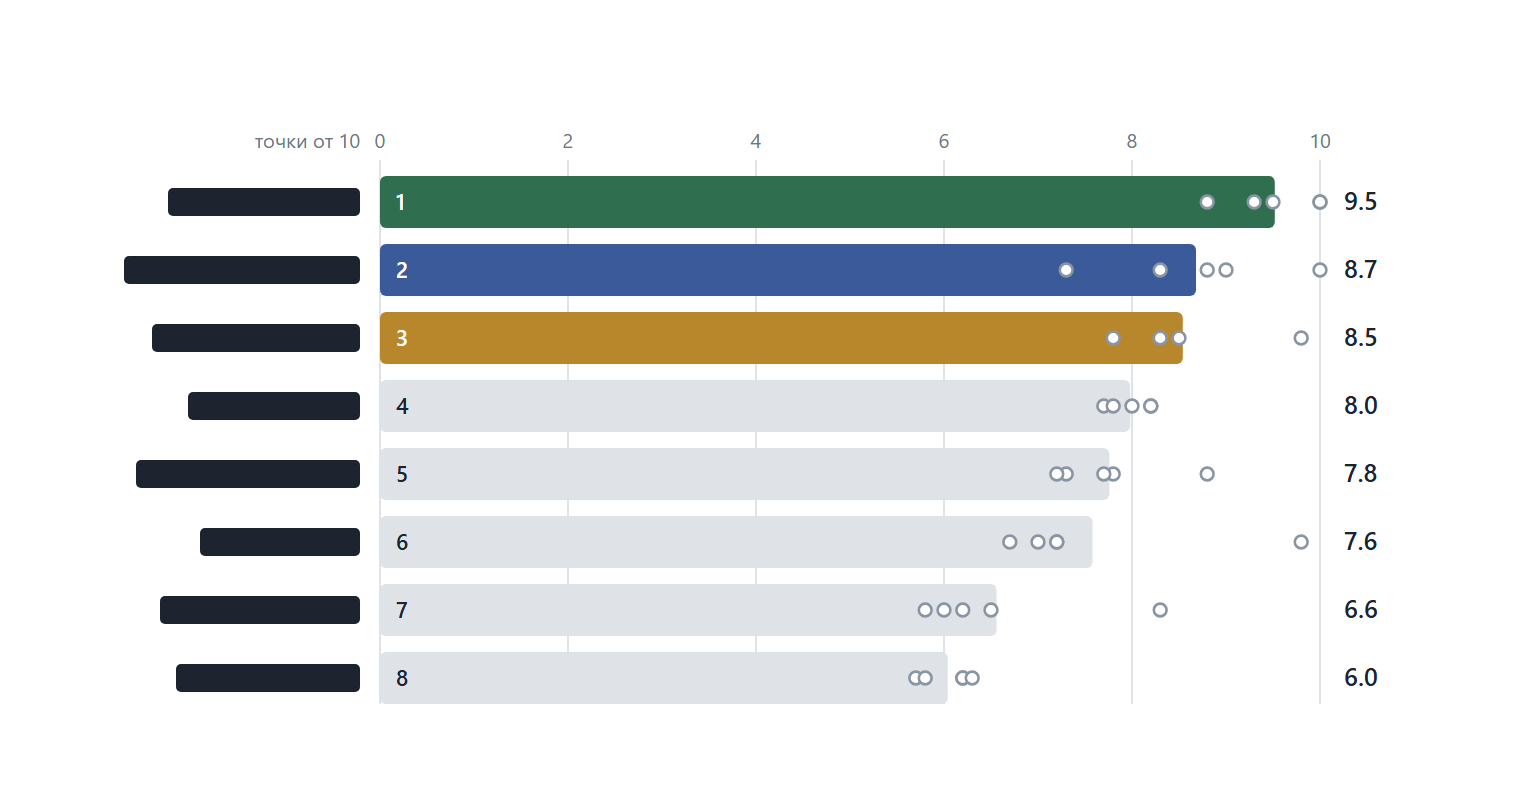
Ето как се наредиха. Единият оценител даде само подредба без точки, затова на графиката са трима.
Какво добавя pipeline-ът
На база на тези резултати пробвах и pipeline за превод, който добавя допълнителна обработка около обикновения превод.
Пуснах четирите най-добри модела наново, този път през pipeline-а. gpt-6-astra и gemini-3.1-pro се качват с по една-две точки, а gemini-3.8-flash и deepseek-v4-pro губят по една. Всеки модел е оценен само спрямо собствените си версии, така че се сравнява само със себе си.
Човешкият превод и оценителят като преводач
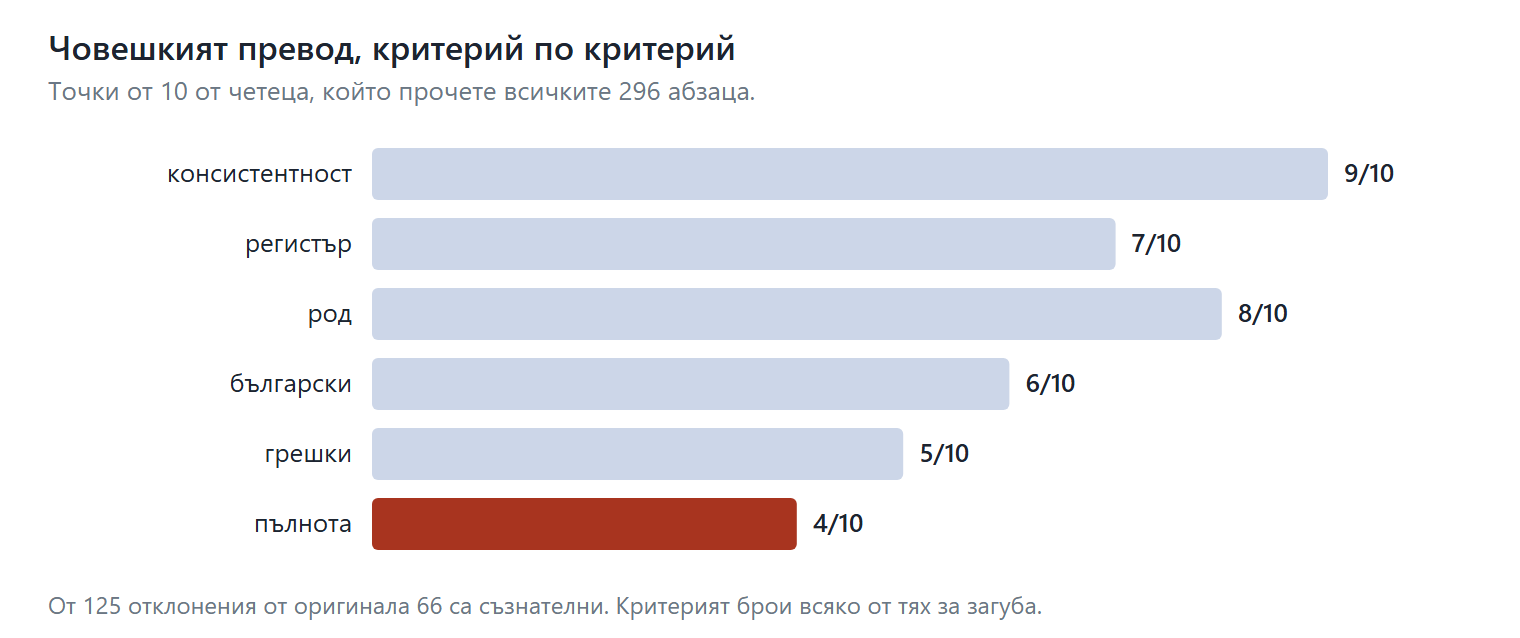
Оцених и издадения превод, направен от човек. Той излезе под най-добрите машини и основната причина е пълнотата. Преводачът съкращава нарочно: от 125 отклонения от оригинала 66 са съзнателни решения, а оценяването брои всяко от тях за загуба, дори когато е сполучливо. Губи точки и на езика. Кратък член стои системно там, където трябва пълен: „кимериеца“, „вашия капитан“, „пътя ти“. Има и неправилно управление, например „пусни ни борда“, и то два пъти. Останали са десетина технически грешки в текста, като пренос в средата на реда („удивле-ние“), удвоени думи и латински букви в кирилски думи. Те най-вероятно идват от сканирането на текста, не от превода. По български получава 6 от 10, при 9 за най-добрия модел.
Преводът е на Иван Златарски, направен около 1991 г. по поръчка на издател, без редакция и коректура. Къде е излязъл на хартия не е ясно и досега.
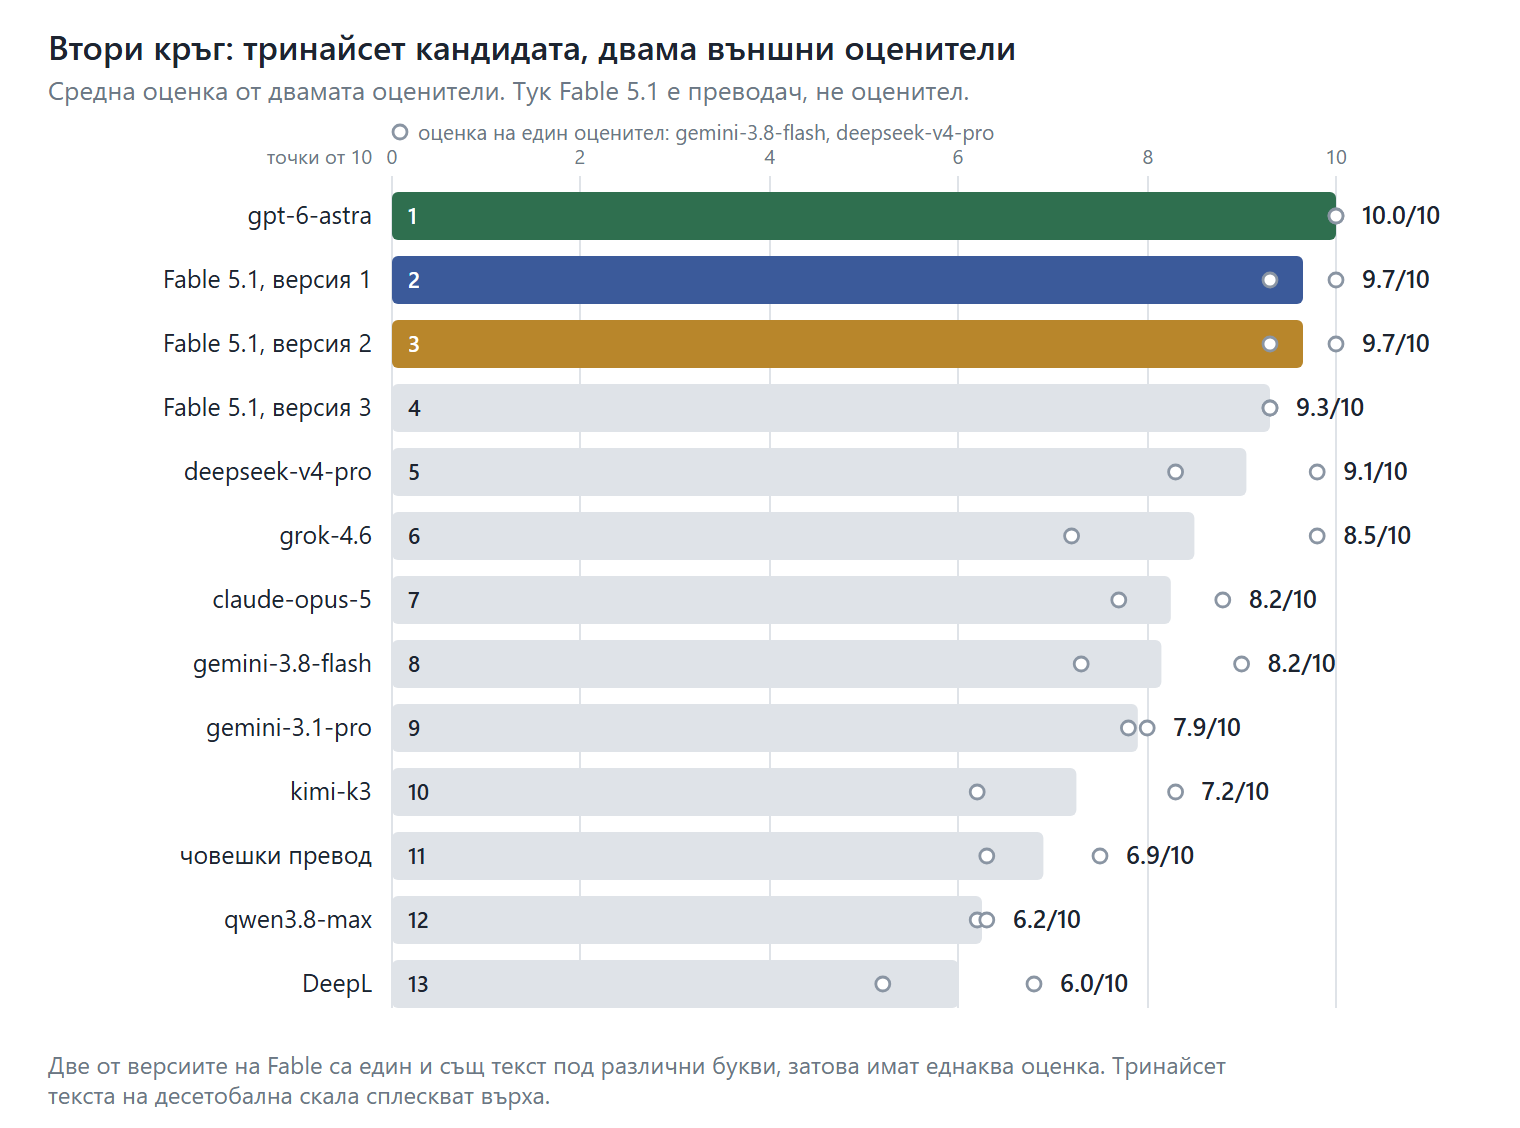
Накрая дадох да превежда и на един от оценителите, Fable 5.1, обикновено и през pipeline-а. Оцениха го двама външни модела, заедно с всички останали преводи наведнъж, за да е обща скалата. Излезе веднага след gpt-6-astra, но не го броя за победа, защото само той знаеше предварително по какво ще бъде оценяван.
И така, кой модел превежда най-добре художествена литература
Като цяло gpt-6-astra показа най-добри резултати във всички кръгове.

gemini-3.8-flash излезе втори и е най-бързият от осемте с голяма разлика.
Също така видях, че pipeline за превод може да промени резултата осезаемо, в едната или в другата посока според модела. Ако тръгна да превеждам художествена литература, ще го направя с pipeline, настроен за модела, който избера.
Ето тук можете да прочетете детайлната статия за направеното изследване: В търсене на най-добрия A.I. преводач на художествена литература – Детайлно.