Scriptorium: цели сайтове с документация и архиви с документи в Markdown
Scriptorium записва сайт с документация на вашия диск като Markdown, по един файл за всяка страница. Това е програма за командния ред, пакетирана като skill за Claude Code и Codex. Самото конвертиране го прави MarkItDown на Microsoft. Scriptorium добавя това, с което MarkItDown не се занимава: намира страниците през sitemap-а, подрежда всяка в папки със същата структура като сайта, оправя връзките между тях и маха менютата и футърите. След това ви казва какво е направил, а числата в този отчет трябва да се балансират. Конвертира и документи от диска, PDF, Word, PowerPoint и Excel, както и цял ZIP архив с такива наведнъж. Безплатен е, под лиценз MIT: github.com/valcheffnet/scriptorium.
Работя с продукти за мониторинг, а документацията им е хиляди страници. Исках я на собствения си диск по две причини. Мога да търся в цялата наведнъж, вместо в един таб на браузъра. И мога да я дам на AI асистент, който тогава отговаря по документацията, а не по памет. Паметта на модела за даден продукт обикновено е с няколко версии назад и греши точно в детайлите, за които питате.
Името идва от стаята в манастира, където текстовете са се преписвали на ръка, страница по страница. Това е и цялото задание: точно копие на чужда работа, за ваше собствено четене.
Защо го написах
Започна като работен процес, който сглобих, за да копирам документацията на Dynatrace, около 4 400 страници. Свърши работа, но беше писан за този един сайт и не можеше да се насочи към друг. Освен това губеше съдържание, без да ми каже, и аз го откривах парче по парче в продължение на седмици.
| Какво се обърка | Какво струваше |
|---|---|
| Имената на файловете се вземаха от последната част на URL-а | 534 от 4 389 страници тихо се презаписаха една друга |
| Иконите се махаха според ширината на картинката | 1 453 клетки от таблици останаха празни на една-единствена страница |
| Идентификаторите на заглавията се губеха при конвертирането | 46% от 8 992 връзки към раздел сочеха към нищото |
| Конверторът слагаше обратна наклонена черта пред долните черти в текста | 57 068 идентификатора записани като CUSTOM\_DEVICE, които търсене за CUSTOM_DEVICE никога няма да намери |
Вградените data: картинки се орязваха | всяка такава картинка на страницата се свеждаше до един и същ низ от 24 знака |
Всяка страница се конвертира и не излезе нито една грешка. Всеки проблем изскочи случайно, дълго след като вече вярвах на резултата и бях построил нещо върху него.
Този с долните черти ми е любимият, защото не е бъг в ничий код. MarkItDown ползва библиотека, наречена markdownify, а тя по подразбиране слага обратна наклонена черта пред _ и * в обикновения текст, за да не станат курсив. В справочната документация повечето идентификатори са написани в обикновен текст, без backticks. Страницата изглежда наред. Търсенето не връща нищо.
Конвертор, който изпусне таблица, пак отчита успех. Около този проблем е построен Scriptorium.
Отчет, който трябва да излезе
Всяко пускане отпечатва уравнение за покритието и то трябва да се балансира:
images = transcribed | skipped | queued | deleted
pages  = converted | failed
Всичко изтрито е записано с URL-а си и причината. Това правило се роди от един лош следобед. Една по-ранна версия броеше картинка, която никой не е поглеждал, по същия начин като картинка, пропусната нарочно. За един следобед получих три различни числа за напредъка на една и съща работа: 762, 596 и 561. Истинското беше 497.
Затова инструментът държи тези два факта отделно. „Никой не е поглеждал тази картинка“ и „някой я погледна и реши, че е украса“ са в различни колони.
Как работи
Пет етапа. Само четвъртият има нужда от модел.
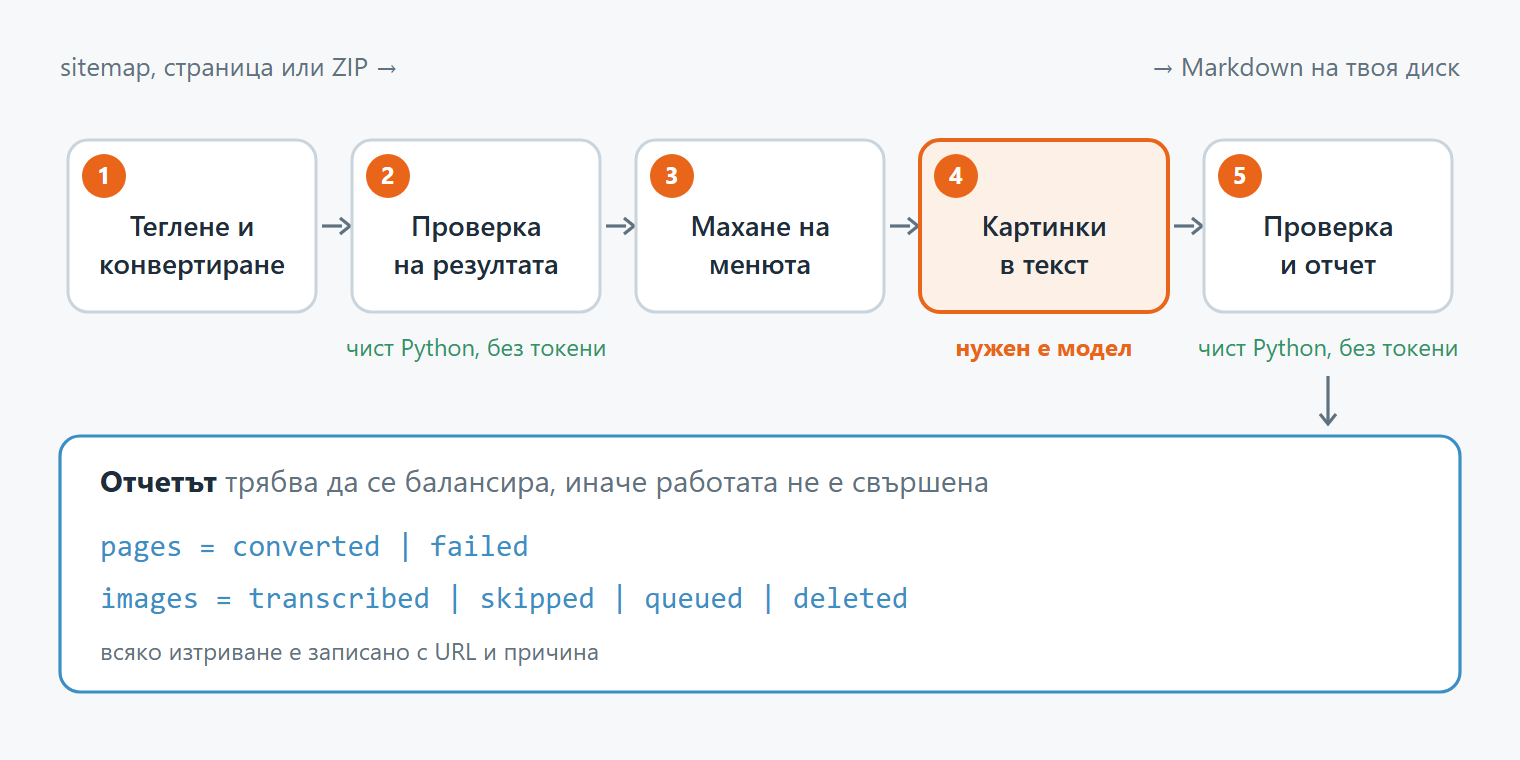
- Теглене и конвертиране. Следва sitemap-а и планира пътя на всеки файл преди първото теглене, така че съвпадение на имена се хваща в плана, а не се открива по-късно като липсваща страница. Всеки файл започва с URL-а, от който е дошъл.
- Проверка на резултата. Търси повредени знаци и сравнява размера на резултата с размера на страницата. Три килобайта текст от страница от 700 KB обикновено значи, че сайтът се рендира в браузъра и сте получили менюто.
- Махане на мебелировката на сайта. Навигация, банери за бисквитки, breadcrumbs, футъри и малките иконки за постоянна връзка до заглавията.
- Картинки в текст. Диаграмата става ASCII рисунка плюс Mermaid диаграма, снимка на екран с код или конфигурация става блок с код или таблица, а украсата се пропуска със записана причина. Това е етапът, който струва заявки към модел, затова решението кои картинки си заслужават е по-важно от самото преписване.
- Проверка и отчет. Чете файловете на диска, вместо да вярва на това, което предишните етапи казват, че са направили.
Работата от етап 4 е отбелязана във файла с коментар, който носи URL-а на картинката. Ако поправите някое правило и конвертирате страницата отново, вече платените преписи остават.
Инсталиране и първо пускане
Трябва ви Python 3.11 или по-нов. Работи и на 3.14.
git clone https://github.com/valcheffnet/scriptorium.git
cd scriptorium
python -m venv .venv
.venv/bin/pip install -r scripts/requirements.txt
.venv/bin/python -m scriptorium doctor
На Windows редът с pip е .venv\Scripts\pip install -r scripts\requirements.txt.
Инсталирайте през файла с изискванията, а не с pip install markitdown[all]. На Python 3.14 тази команда не намира нищо за инсталиране и спира. По-лошият случай е обикновеното pip install markitdown без екстри: минава успешно, а поддръжката за PDF и Office липсва до първия път, в който ви потрябва. doctor проверява точно това, заедно с версията на Python и User-Agent-а, който ще изпраща.
Виртуалната среда заема около 420 MB. За това, което прави инструментът, е много, и повечето са зависимости на MarkItDown.
За да видите резултата, преди да го насочите към нещо голямо, конвертирайте малък публичен сайт. Отнема около двайсет секунди:
python -m scriptorium --profile mkdocs convert https://www.mkdocs.org/sitemap.xml -o ./try
python -m scriptorium verify ./try
После отворете няколко от файловете. Винаги започвайте с пилот (--limit 3) и четете какво излиза. Правилата за махане на менютата се настройват по това, което виждате там, а да ги настройвате след пълно пускане значи да конвертирате всичко два пъти.
Един капан от Windows. Git Bash превръща аргумент, който започва с наклонена черта, като --strip-prefix /docs, в Windows път, преди Python изобщо да го види. Пускането завършва с код 0 и не маха нищо. Scriptorium вече отказва префикс, който прилича на Windows път, но смисълът е в навика. След всяко пускане проверявайте какво всъщност е направено.
Като skill
Хранилището е и skill: SKILL.md е в корена му, в отворения формат за skills, който четат и Claude Code, и Codex. Клонирайте го направо в папката, в която агентът ви търси skills, и агентът може да изпълни цялата процедура вместо вас, включително за папка, пълна с документи.
За Claude Code, в домашната папка, за да работи във всеки проект:
git clone https://github.com/valcheffnet/scriptorium.git ~/.claude/skills/scriptoriumЗа Codex мястото е ~/.agents/skills/:
git clone https://github.com/valcheffnet/scriptorium.git ~/.agents/skills/scriptoriumСлед това направете Python средата в тази папка, по същия начин като по-горе. Skill-ът казва на агента как да ползва инструмента, а инструментът върши работата.
На чужд сървър
Настройките по подразбиране приемат, че сайтът не е ваш. Чете и спазва robots.txt, включително Crawl-delay. Чака една секунда между заявките към един и същ хост и отстъпва, когато сървърът каже, че е зает. User-Agent-ът казва какъв е инструментът. Представя се за браузър само ако подадете --as-browser, което е за вашите собствени сайтове.
Показва ви и какво казва сайтът за използване от AI. robots.txt без забрана пак може да декларира, че съдържанието не е за обучение на AI. Липсата на забрана не е съгласие, затова инструментът го отчита, вместо да го прескочи.
Резултатът е локално копие на материал, който някой друг е написал. Всеки файл пази URL-а на източника си. В инструмента няма нищо за връщане на чужда документация обратно в публичния интернет, и това е нарочно.
Какво още не е готово
Scriptorium е същият работен процес, пренаписан така, че да работи с всеки сайт, като всеки от тези провали е станал проверка или тест. Работният процес зад него е копирал цялата документация на Dynatrace. Самият пренаписан код засега е конвертирал от край до край сайтове до 108 страници. Идва с 32 офлайн теста, които минават за около секунда, и пет профила за сайтове: generic, MkDocs, MkDocs Material, Docusaurus и Sphinx.
Не тегли картинките вместо вас, а ви дава списък с тези, които си струва да се преписват. Още не обхожда сайтове без sitemap, защото календарите и страниците с търсене генерират безкрайно много URL-и, а обхождане без ясни правила кога да спре влиза право в тях.
Пускал съм го само на Windows 11. Ако пуснете тестовете на macOS или Linux, ще се радвам да науча резултата, независимо дали минават.
Какво научих
Кодът може да се пренапише за ден. Списъкът с начините, по които конвертирането от HTML към Markdown губи съдържание, се събираше седмици, от истински провали. Той е в references/traps.md, за всеки случай как да го хванете и какво да направите. Ако вече имате конвертирана документация, прочетете този файл, преди да решите, че всичко е наред.
Моето правило от всичко това: когато инструмент каже, че е успял, отворете файла.